對人體有功能的不飽和脂肪酸 omega-3 有三種,分別為植物裡的 ALA (α-linolenic acid),以及動物裡 EPA (eicosapentaenoic acid) 和 DHA (docosahexaenoic acid)。EPA 和 DHA 通常在魚裡,大家應該都知道或是聽過,尤其之前有個廣告好像是「魚肝油加蓋,保護眼睛,鞏固牙齒」的就有出現 DHA 的樣子。(咦,是否不小心洩漏的年紀?那個童星現在都是大人了吧?XD)之前有研究顯示,如果老鼠少了運送 DHA 跨過 BBB (blood-brain barrier) 進入腦部的蛋白質 Mfsd2a,就會引起嚴重的腦部和視網膜問題。
脂肪酸有不少功能,其中一個就是建構細胞膜,細胞膜的構造就是兩層尾對尾的脂肪酸(lipid bilayers),除此之外,它還參與了訊息傳遞(signalling)的功能。DHA 很容易被氧化,氧化後會產生調節訊息傳遞的物質 epoxide。epoxide 會被酵素 sEH (soluble expoide hydrolase) 降解變成 19,20-DHDP (19,20-dihydroxydocosapentaenoic acid),是視網膜裡 DHA 的主要代謝物。
之前的研究顯示,視網膜病變的要角是 VEGF (vascular emdothelial growth factor),這個蛋白質會在低氧的情況下表現,作用在血管內皮細胞(vascular endothelial cells)的接收器上(VEGF receptor),使血管變得脆弱易出血,用抑制 VEGF 的藥物可以使視網膜病變不再惡化,但並非對每個病患都有用,這表示 VEGF 可能並非唯一的致病因子。而這篇研究顯示,sEH 也參與了糖尿病引起的視網膜病變(diabetic retinopathy) [註 1]。
註 1:糖尿病視網膜病變的特徵有周皮細胞(pericytes)減少,無細胞微血管(acellular capillary)增生等等。)
DHA --> epoxide --> 19,20-DHDP
在這個研究裡,科學家讓其中一種神經細胞 Müller glia cells 能夠大量表現 sEH,結果出現了視網膜病變開始的徵兆,包括了 pericytes 的衰變,acellular capillary 增生造成不正常血液運送,血清滲漏出血管到週邊的細網膜組織,最終造成視網膜的血液循環不正常,細網膜出血等等。但是,當用藥物抑制 sEH 的表現或功能的話,可以預防這些症狀的發生,表示 sEH 是造成視網膜病變的因子。研究作者表示,造成病症的原因可能並非是 DHA 或 epoxide 不足,而是因為其代謝物 19,20-DHDP 所造成的。他們接著發現另外有三個蛋白質和病症有關:presenilin 1 (PSEN1) [註 2], vascular endothelial-cadherin (VE-cadherin) 和 neural-cadherin (N-cadherin)。這三個蛋白質皆位於細胞膜中,PSEN1 和 cadherins 會和膽固醇(cholesterol)組合在一起成為細胞膜中的 lipid rafts,cadherins 的功用是把兩個細胞緊密結合。但是當 19,20-DHDP 增加的話,這些蛋白和膽固醇的相互結合會被影響,cadherins 會被內收進細胞中(endocytosed),使得細胞和細胞之間不再密合,並且內皮細胞的滲透度也增加了。
註 2: PSEN1 較為人知的可能是它的突變會導致阿茲罕默症
在老鼠實驗中,他們用了會在四個禮拜後出現高血糖(hyperglycaemia)症狀的糖尿病鼠。他們發現這些老鼠在三個月大的時候,視網膜內的 sEH 量會顯著增加。在六個月大的時候,視網膜裡的 sEH 活動會增加,並且出現視網膜病變的症狀。在一歲大的時候,sEH 的活動更為增加,並且老鼠眼內的 19,20-DHDP 也增加了。如果正常老鼠被餵食高醣、高脂肪連續二十週,出現了高血糖的症狀,但還沒有視網膜病變的情況,其 sEH 的表現量也有增高的現象。不過,在給老鼠 sEH inhibitor t-AUCB 後,19,20-DHDP 的生產量顯著降低了,視網膜病變的症狀也停止了。
重點整理:
- 糖尿病鼠的視網膜裡的 sEH 和 19,20-DHDP 量增加
- sEH 的過量表現會使正常老鼠的視網膜出現糖尿病鼠有的視網膜病變症狀。
- 19,20-DHDP 會影響細胞膜中膽固醇和 PSEN1, N-cadherin 和 VE-cadherin 的結合,造成細胞之間無法密合。
- sEH 的抑制劑可以預防周細胞的衰亡和血管滲透等視網膜病變的症狀。
Article:
Nature / A dark side to omega-3 fatty acids (Dec 2017)
Paper:
Hu et al, Inhibition of soluble epoxide hydrolase prevents diabetic retinopathy. Nature (2017)
Other resources:
NIH / Omega-3 fatty acids
2018年7月14日 星期六

2018年7月7日 星期六
用沙門氏菌來治療癌症
癌細胞可以生存的一個點,就是它們突變後一直增生,而且不會被免疫系統攻擊,因為是自體細胞,而這個研究就是用沙門氏菌去感染癌細胞,讓它能被免疫系統認證,然後攻擊。
要怎麼引發免疫系統去攻擊癌細胞呢?韓國全南大學的學者發現一種水產細菌 Vibrio vulnificus (創傷弧菌) 會引起劇烈的免疫反應。創傷弧菌生存在水中,主要是 18C 以上的海洋,會被甲殼類生物(例如牡蠣或蝦子)吃進去,以此為傳播的媒介,人類吃進帶有創傷弧菌的海產會出現嘔吐或腹瀉等症狀。這個研究改造了對人體較無害的沙門氏菌株 Salmonella typhimurium,讓它能夠製造和分泌 vibrio 的一種蛋白質 FlaB。癌細胞被感染了改造過後的沙門桿菌後,分泌的 FlaB (flagellin B) 會引起免疫系統來攻擊它。他們發現 FlaB 引起的免疫反應是透過 TLR4 (toll-like receptor 4) signaling 來引發免疫細胞 -- 像是 monocytes, macrocyotes 和 neutrophils -- 來消滅癌細胞。他們把改造過後的沙門桿菌打到二十隻長有人類大腸癌(colon cancer)腫瘤的老鼠裡,發現三天後雖然老鼠肝臟、肺和脾臟裡的細菌都被免疫細胞清除了,但是帶有沙門氏菌的腫瘤細胞還在,不過在一百二十天之後,有十一隻老鼠的腫瘤消失了。有趣的是,直接把純化的 FlaB 打入腫瘤並沒有治療的效果,但是如果和無法分泌 FlaB 的沙門氏菌一起打入腫瘤,八隻老鼠中有三隻的腫瘤變小了。
之後,他們把轉移中(metastasizing)的人類大腸癌細胞移植到老鼠身上,然後在給牠們打入改造過後會分泌和不會分泌 FlaB 的沙門氏菌,發現被打入不會分泌 FlaB 沙門氏菌的老鼠在 27 天後,身上的癌細胞已大量轉移到各處了(只打入 PBS 的老鼠有 91 處轉移,打入不會分泌 FlaB 沙門氏菌的則有 26 處出現轉移腫瘤),但是被打入會分泌 FlaB 沙門氏菌的老鼠只有四個轉移後的腫瘤。
他們利用 TLR4 K/O 和 TLR5 K/O 老鼠研究,發現如果沒有 TLR4 的話,帶有 FlaB 的沙門氏菌便沒有療效,表示其引起的免疫反應是透過 TLR4 signaling pathway,細菌無法啟動 monocytoes, macrophages 和 neutrophils 前來攻擊癌細胞,而之後 TLR5 signalling 則會增強免疫細胞抑制腫瘤的反應。
雖說用細菌引起免疫細胞來消滅癌細胞看起來頗有療效,但我覺得只有 55% 的話感覺有點低,另外那 45% 無法消滅腫瘤的原因是什麼呢?
Article:
Science / Scientists turn food poisoning microbe into powerful cancer fighter (2018)
Paper:
JH Zheng et al, Two-step enhanced cancer immunotherapy with engineered Salmonella typhimurium secreting heterologous flagellin. Science Translational Medicine (2017)
2018年6月10日 星期日
降解蛋白質的密碼
不知道大家對 degron 的了解有多少。細胞內的蛋白質經過一段時間後會被降解(degradation),降解的方式有兩種:proteasomal 和 lysosomal。顧名思義,proteasomal 就是被 proteasome 降解,lysosomal 就是被 lysosome 降解。(廢話 XD)
大家可能已經知道的蛋白質被送到 proteasome 降解前,會被 E3 ligase 加一個標籤,就是 ubiquitin。E3 ligase 的輔助蛋白(adaptors)會幫它找到要降解蛋白質,怎麼找呢?就是辨識蛋白質尾端(C-terminus)的幾個氨基酸,那幾個氨基酸就是 degron。而不同的 adaptors 辨識的氨基酸也不同。我會知道 degron 是因為之前的研究,當你在蛋白質後面加上 degron,它就會被降解。如果說你知道 A 蛋白和 B 蛋白的某個片段 interact,你可以在 B 蛋白的那個片段後面加上 degron,利用加惹 degron 的片段去 knock down 蛋白 A。(想了解如何應用 degron 的話可以參考我前實驗室老闆發表的這篇: X Fan et al, Nature Neuroscience 2014; doi: 10.1038/nn.3637)
這篇研究做了一些分析,找出當蛋白質尾端是哪幾個氨基酸時,會被 adaptors 辨識出來,然後讓 E3 ligase 幫它標籤後送去降解。他們分析了兩種 E3 ligase:CRL2 和 CRL4。
CRL2 的其中一個 adaptor KLHDC3 辨識的是最尾端(-1 position)是否為 glycine,還有倒數第二(-2 position)是否為鹼性(basic)氨基酸,像是 arginine (R) 和 lysine (K),也就是說 KLHDC3 辨識的最後兩氨基酸主要為 -RG 和 -KG。另一個 adaptor KLHDC2 辨識的則是 -GG,而 LKHDC10 辨識的是 -WG, -PG 和 -AG。另外,APPBP2 辨識的 -RxxG 不需要在最後,比較常見的是 RxxGx 和 RxxGxx。
他們分析的另一個 E3 ligase Cul4 (CRL4),其 adaptors 辨識的氨基酸又不同。它的 DCAF12 辨識的是 -EE,而它的 TRPC4AP 辨識的是倒數第三個的 arginine (R-3 motif)。
除了以上的規則外,當最後一個氨基酸是 glycine 的時候會被送去降解,但是當倒數第二(-2 position)和第三個(-3 position)氨基酸是酸性(acidic)或是避水性(hydrophobic)的時候,像是 aspartic acid (D), glutamic acid (E), isoleucine (I) 或是 valine (V) 的時候,則會使蛋白質避免掉降解,例如當尾端是 -DG 或是 -EG 的時候。另外,當酸性氨基酸配上 lysine 的時候,也就是 -DK 和 -EK 的時候,也會使蛋白質穩定,避免被降解。
看到這裡,可能會有個疑問,那這樣不是會有一堆蛋白質被降解掉嗎?有趣的是他們分析後發現,大多數的蛋白質尾端都不是 glycine,而且這個現象只出現在 eukaryotic 和病毒的蛋白,細菌的蛋白質尾端是 glycine 明顯多很多,可能是因為細菌並沒有 proteasome。
Degron 的應用有其優缺點,優點是你只要知道 interaction site,就可以 knock down (K/D) 任何蛋白,而且它很短,所以容易製作。缺點則是並非所有的 interaction site 都可以拿來用,需要 affinity 夠強,有些 papers 雖說用 co-IP 找到和確認 binding motifs,但是裝上 degron 後發現它不夠強到可以 K/D 蛋白質,另外就是它不夠 stable。
原論文:
I Koren et al, The Eukaryotic Proteome Is Shaped by E3 Ubiquitin Ligases Targeting C-Terminal Degrons. Cell (2018)
2018年5月28日 星期一
偏頭痛的藥物研發
你有偏頭痛嗎?全世界有約 12% 的人年發生一次偏頭痛,女性發生的機率是男性的三倍,美國的 Migraine Research Foundation 估計美國員工每年因為偏頭痛請的病假共約 113 百萬天。
很久以前偏頭痛被認為是因為血管擴張(dilated)造成血流不正常,因此那時候給的藥都是收縮血管的藥,例如 ergotamine。不過 ergotamine 可能會使血管過度收縮,所以後來改用 triptans,其抑制偏頭痛的效果還可以,吃的人約有五、六成有改善,只是它並非對每個人都有用,且有的人是吃得越多,頭痛反而越頻繁。後來,一連串的 fMRI 研究發現,不正常的血流和偏頭痛似乎沒有關係 XD。之後,科學家試著找其他引發偏頭痛的原因,發現腦神經的電流傳遞如果被阻斷,造成的 cortical spreading depression (CSD) 可能也扮演著重要的角色,因為它會攪亂三叉神經(trigeminal nerve)和三叉血管系統(trigeminovascular system)。
接著,UCSD 的神經學家在研究一個控制體內鈉和鈣的甲狀腺賀爾蒙 calcitonin 的時候,發現同樣的 calcitonin 基因在腦中會製造出不太一樣的蛋白,也就是 alternative gene slicing,這個研究後來發表在 1982 年的 Nature。之後,CGRP (calcitonin gene-related peptide)被發現,其參與了痛覺,也控制血流。後來,瑞典的神經學家發現當偏頭痛發生時,三叉血管系統裡的神經(trigeminovascular nerves)會釋放出 CGRP,使血管擴張,並且會傳導痛覺。這些發現引起藥廠的興趣,德國的 Boehringer Ingelheim 和美國的 Merch 相繼研發抑制 CGRP receptor 的小分子藥物,可惜不是有不好的副作用,就是對肝臟有害。
2004 年開始,有些藥廠試著研發針對 CGRP 的抗體藥,不過後來因為 FDA 對止痛藥在安全上的要求越來越嚴苛,加上市場價值難以估計,範圍廣到從約為二十億美金到五百億美金,於是很多藥廠紛紛退縮。接著來到 2013,之前生技公司 Rinat 研發的抗體藥經過幾番轉手到了另一間生技公司 Teva 手中,此藥被命名為 TEV-38125,目前在臨床二期階段,顯示出來的效果不錯。除了 Teva 之外,另外有 Alder Biopharmaceuticals, Eli Lilly 和 Amgen 研發的抗體藥也在 Phase II,且效果也都不錯,這四間公司在爭第一個拿到 FDA 許可。
目前的臨床沒發現有什麼嚴重的副作用,不過也有科學家擔心,因為它會抑制血管擴張,如果用在有心血管疾病的患者身上,會不會使病情加重還未可知。
[2019-10-20 update] Amagen 研發的治療偏頭痛的新藥 Aimovig (erenumab) 已於去年通過 FDA 許可。
延伸閱讀:關於偏頭痛
Article:
Science / FDA just approved the first drug to prevent migraines. Here’s the story of its discovery—and its limitations
SG Amara et al, Alternative RNA processing in calcitonin gene expression generates mRNAs encoding different polypeptide products. Nature (1982)
2018年5月5日 星期六
Python | 用線上 repl.it 寫程式和一些基礎語言
Python 除了可以用之前介紹的 jupyter notebook 外,也可以線上直接寫:repl.it
repl.it 除了可以讓你線上寫 code 之外,也可以自學。先申請一個帳號,登入後在右上角會出現功能列:learn/teach, student, my repls
點入 learn/teach 後下面就會出現很多線上課程,像是 Python, Javascript 等等,我目前是在試 Auto-Graded Course with Solutions 這個課,主要是教你怎麼寫程式,如果你之前有學過 C++ 之類的可能會比較容易上手。

(點圖可以放大)
如果直接連上上面那個網址,就會出現下面這個 coding 的頁面,最左欄是檔案夾,你可以登入後把你寫的東西存入。中間那欄是寫 code 的地方,寫好後點上面的 "run",就會在最右邊那欄跑出來。
例如你在中間欄打入:
input() 這個功能是接受使用者輸入的東西,下面會解釋。
int() 的功能跟 R 的一樣,是指 integer,把輸入的東西變成數字的整數。str() 則是可以把數字變成 string。
print() 就是顯示出 () 裡面的結果
之前關於 Python 的那篇有簡單介紹一下,有興趣的可以先看那篇。(注意,這兩篇教的都是 Python 3.xx 以上的版本,Python 2.xx 的語法會有點不同。例如在 Python 2.xx 的版本裡,input() 的預設是 integer,但是在 Python 3.xx 裡則是 string,所以在上面的例子裡,a 和 b 需要用 int(input()) 把輸入的東西變成 integer,而在 Python 2.xx 的版本裡的話則不用,直接用 input() 讀出來的就是數字。)
上面寫好的 code 在跑了之後就會呈現在右欄,也就是你輸入的第一個數字會是 a,第二個數字會是 b,然後它會算出 a + b。所以當我輸入 3 和 5 後,它會算出 8,變成下面這樣:
上面的 3 和 5 是我輸入的數字,8 是它算出來的。
之前那篇有提過,Python 讀取的資料型態分為三種:string (字), integer (整數), float (有小數點的)。在數字外加 str() 就會把它變成 string。另外,在 print() 的功能裡,在字的外面加上 " " 或是 ' ' 的話,就會把它變成 string。用 int() 功能就會把獨到的東西變成 integer。
上面的程式簡單介紹了 integer,接下來介紹一下 string 會在哪裡用到。如果你想要在使用者輸入自己的名字後,出現歡迎詞 "Hello, xxx!",那要怎麼寫呢?我們來拆解一下句子。
Hello, xxx! 這個句子可以拆成三部分:
"Hello, " 是 string。
"xxx" 是使用者輸入的名字,也就是 input()。
"!" 是 string。
要如何把這三個東西結合在一起變成一個句子顯示出來呢?有兩個方法,一個是用 +,另一個是用 , 。
在 Python 裡面,+ 除了有數學的功能,在 print() 裡面還有結合顯示的功能。
所以這個句子要讓它呈現,需要這樣寫:
Hello, 和 ! 因為是 string,所以要用 " " 括起來。注意,"Hello, " 的後面有個空格,它也是 string 的一部份,所以要放進去,如果沒有放進去,逗號的後面就會直接連名字,變成:
如果是用 , 的話,就是在每組字後面加 , ,而且每組之間會出現空白, 也就是說上面用 + 時需要自己加空格的部分,用 , 的話就不需要。例如上面的句子用 , 寫的話,就是這樣:
不過,因為每組字中間會出現空格,所以你輸入名字後,出現的會是:
你也可以把使用者輸入的名字指定為一個 variable,例如 name,指令寫成這樣:name = input()
於是,中間欄的程式碼可以這樣寫:
跑了程式之後,當你在右邊輸入名字,它就會出現:
Peter 是你輸入的名字,"Hello, Peter!" 和 "Hello, Peter !" 是程式讀取後顯示出來的 greetings,看出用 + 和用 , 的不同了嗎?
另外,+ 和 , 除了空格這個部分不一樣外,還有一個就是 + 不同種類的不能相加在一起,也就是說 interger 和 string 不能相加在一起顯示,需要把它們變成同類。用 , 的話則沒有這個限制。
例如我想要讓使用者輸入自己的名字和年齡後,出現這樣的句子:xxx is ??? years old
我們可以把句子拆成這樣:
"xxx" 是使用者輸入的名字,所以是 input()。
"is" 是 string
"???" 是使用者輸入的年齡,所以是 input()。
"years old" 是 string
跟上面一樣,可以把名字指定為 name,年齡指定為 age。
然後用 + 來寫的話就是:(注意要自己空格和把數字改為 string)
用 , 來寫的話則是:
除了讓使用者輸入,Python 跟 R 一樣也可以指定 variable,例如我們可以指定 year 為 1990,birthmonth 為 Feb。
Feb 是 string 所以要加 " "。上面的程式碼跑出來就會在右欄顯示出:
把上面的程式碼混在一起,比較完整的打在中間那欄:
把程式碼跑完後,在右欄輸入名字和年齡:Peter, 28
就會出現:
看出用 + 和用 , 的不同呢嗎?
最後,+ 用在數字是把兩個數字加在一起,但是用在 string 是把兩個字連在一起。咦,這不是上面講過了嗎?下面用數字做例子,解釋一下為什麼要再次提出來讓大家注意。
例如我想要顯示:The sum of a and b is (a + b)
把句子拆開來看就是:(記得要把句子中的空格算進 string 裡面)
"The sum of " 是 string
a 是 input(),是數字。
" and " 是 string
b 是 input(),是數字。
" is " 是 string
a + b 是算出來的結果,是 integer。
因為句子是 string,所以要用 + 的話,需要把裡面數字的部分在 print() 裡面設為 string,於是就會變成這樣:
如果用 , 的話就不需要,可以寫成這樣:
前面說過,Python 3.xx 裡的 input() 預設是 string,所以要把 a 和 b 設為 integer。
a = int(input())
b = int(input())
另外加 c 和 d 沒有設 int() 的做比較:
c = input()
d = input()
跟 R 一樣,可以查 variable 的格式是什麼。在 R 裡面是用 class() 的功能,在 Python 裡是用 type() 。查詢 a, b, c, d 的格式:
算算看 a + b 和 c + d 不同在哪:
用 + 和 , 的功能顯示:The sum of a and b is ....
把上面的程式碼整合,打在中間欄完整的 code 是:
跑程式碼後,在右邊輸入 a, b, c, d 四個數字,例如 3, 4, 5, 6,就會出現:
3, 4, 5, 6 是你輸入的數字,後面幾行是程式算出來的。可以看到 3 和 4 是 integer,5 和 6 是 string,所以 3 + 4 算出來是 7,但是 5 + 6 算出來是 56,因為是兩個 string 連在一起,而不是兩個數字加在一起。
以上,這篇的 Python 介紹就先到這吧。
repl.it 除了可以讓你線上寫 code 之外,也可以自學。先申請一個帳號,登入後在右上角會出現功能列:learn/teach, student, my repls
點入 learn/teach 後下面就會出現很多線上課程,像是 Python, Javascript 等等,我目前是在試 Auto-Graded Course with Solutions 這個課,主要是教你怎麼寫程式,如果你之前有學過 C++ 之類的可能會比較容易上手。

(點圖可以放大)
如果直接連上上面那個網址,就會出現下面這個 coding 的頁面,最左欄是檔案夾,你可以登入後把你寫的東西存入。中間那欄是寫 code 的地方,寫好後點上面的 "run",就會在最右邊那欄跑出來。
例如你在中間欄打入:
|
a = int(input()) b = int(input()) print(a + b) |
input() 這個功能是接受使用者輸入的東西,下面會解釋。
int() 的功能跟 R 的一樣,是指 integer,把輸入的東西變成數字的整數。str() 則是可以把數字變成 string。
print() 就是顯示出 () 裡面的結果
之前關於 Python 的那篇有簡單介紹一下,有興趣的可以先看那篇。(注意,這兩篇教的都是 Python 3.xx 以上的版本,Python 2.xx 的語法會有點不同。例如在 Python 2.xx 的版本裡,input() 的預設是 integer,但是在 Python 3.xx 裡則是 string,所以在上面的例子裡,a 和 b 需要用 int(input()) 把輸入的東西變成 integer,而在 Python 2.xx 的版本裡的話則不用,直接用 input() 讀出來的就是數字。)
上面寫好的 code 在跑了之後就會呈現在右欄,也就是你輸入的第一個數字會是 a,第二個數字會是 b,然後它會算出 a + b。所以當我輸入 3 和 5 後,它會算出 8,變成下面這樣:
|
3 5 8 |
上面的 3 和 5 是我輸入的數字,8 是它算出來的。
|
在 R 裡面設定一個 variable 是用 <-,例如上面的例子,在 R 裡面可以寫成這樣: a <- 3 b <- 5 print(a + b) |
之前那篇有提過,Python 讀取的資料型態分為三種:string (字), integer (整數), float (有小數點的)。在數字外加 str() 就會把它變成 string。另外,在 print() 的功能裡,在字的外面加上 " " 或是 ' ' 的話,就會把它變成 string。用 int() 功能就會把獨到的東西變成 integer。
上面的程式簡單介紹了 integer,接下來介紹一下 string 會在哪裡用到。如果你想要在使用者輸入自己的名字後,出現歡迎詞 "Hello, xxx!",那要怎麼寫呢?我們來拆解一下句子。
Hello, xxx! 這個句子可以拆成三部分:
"Hello, " 是 string。
"xxx" 是使用者輸入的名字,也就是 input()。
"!" 是 string。
要如何把這三個東西結合在一起變成一個句子顯示出來呢?有兩個方法,一個是用 +,另一個是用 , 。
在 Python 裡面,+ 除了有數學的功能,在 print() 裡面還有結合顯示的功能。
所以這個句子要讓它呈現,需要這樣寫:
| print("Hello, " + input() + "!") |
Hello, 和 ! 因為是 string,所以要用 " " 括起來。注意,"Hello, " 的後面有個空格,它也是 string 的一部份,所以要放進去,如果沒有放進去,逗號的後面就會直接連名字,變成:
| Hello,xxx! |
如果是用 , 的話,就是在每組字後面加 , ,而且每組之間會出現空白, 也就是說上面用 + 時需要自己加空格的部分,用 , 的話就不需要。例如上面的句子用 , 寫的話,就是這樣:
| print("Hello,", input(), "!") |
不過,因為每組字中間會出現空格,所以你輸入名字後,出現的會是:
| Hello, xxx ! |
你也可以把使用者輸入的名字指定為一個 variable,例如 name,指令寫成這樣:name = input()
於是,中間欄的程式碼可以這樣寫:
|
name = input() print("Hello, " + name + "!") print("Hello,", name, "!") |
跑了程式之後,當你在右邊輸入名字,它就會出現:
|
Peter Hello, Peter! Hello, Peter ! |
Peter 是你輸入的名字,"Hello, Peter!" 和 "Hello, Peter !" 是程式讀取後顯示出來的 greetings,看出用 + 和用 , 的不同了嗎?
另外,+ 和 , 除了空格這個部分不一樣外,還有一個就是 + 不同種類的不能相加在一起,也就是說 interger 和 string 不能相加在一起顯示,需要把它們變成同類。用 , 的話則沒有這個限制。
例如我想要讓使用者輸入自己的名字和年齡後,出現這樣的句子:xxx is ??? years old
我們可以把句子拆成這樣:
"xxx" 是使用者輸入的名字,所以是 input()。
"is" 是 string
"???" 是使用者輸入的年齡,所以是 input()。
"years old" 是 string
跟上面一樣,可以把名字指定為 name,年齡指定為 age。
|
name = input() age = input() |
然後用 + 來寫的話就是:(注意要自己空格和把數字改為 string)
| print(name + " is " + str(age) + " years old") |
用 , 來寫的話則是:
| print(name, "is", age, "years old") |
除了讓使用者輸入,Python 跟 R 一樣也可以指定 variable,例如我們可以指定 year 為 1990,birthmonth 為 Feb。
|
year = 1990 birthmonth = "Feb" print(birthmonth, year) |
Feb 是 string 所以要加 " "。上面的程式碼跑出來就會在右欄顯示出:
| Feb 1990 |
把上面的程式碼混在一起,比較完整的打在中間那欄:
|
name = input() age = input() birthmonth = "Feb" year = 1990 print(name, "was born in", birthmonth, year) print(name, "is", age, "years old") print(name + " was born in " + birthmonth + str(year)) print(name + " is " + str(age) + " years old") |
把程式碼跑完後,在右欄輸入名字和年齡:Peter, 28
就會出現:
|
Peter 28 Peter is 28 years old Peter was born in Feb 1990 Peter is 28 years old Peter was born in Feb1990 |
看出用 + 和用 , 的不同呢嗎?
最後,+ 用在數字是把兩個數字加在一起,但是用在 string 是把兩個字連在一起。咦,這不是上面講過了嗎?下面用數字做例子,解釋一下為什麼要再次提出來讓大家注意。
例如我想要顯示:The sum of a and b is (a + b)
把句子拆開來看就是:(記得要把句子中的空格算進 string 裡面)
"The sum of " 是 string
a 是 input(),是數字。
" and " 是 string
b 是 input(),是數字。
" is " 是 string
a + b 是算出來的結果,是 integer。
因為句子是 string,所以要用 + 的話,需要把裡面數字的部分在 print() 裡面設為 string,於是就會變成這樣:
| print("The sum of " + str(a) + " and " + str(b) + " is " + str(a + b)) |
如果用 , 的話就不需要,可以寫成這樣:
| print('The sum of', a, 'and', b, 'is', a+b) |
前面說過,Python 3.xx 裡的 input() 預設是 string,所以要把 a 和 b 設為 integer。
a = int(input())
b = int(input())
另外加 c 和 d 沒有設 int() 的做比較:
c = input()
d = input()
跟 R 一樣,可以查 variable 的格式是什麼。在 R 裡面是用 class() 的功能,在 Python 裡是用 type() 。查詢 a, b, c, d 的格式:
| print(type(a), type(b), type(c), type(d)) |
算算看 a + b 和 c + d 不同在哪:
|
print(a + b) print(c + d) |
用 + 和 , 的功能顯示:The sum of a and b is ....
|
print("The sum of " + str(a) + " and " + str(b) + " is " + str(a + b)) print('The sum of', a, 'and', b, 'is', a+b) |
把上面的程式碼整合,打在中間欄完整的 code 是:
|
a = int(input()) b = int(input()) c = input() d = input() print(type(a), type(b), type(c), type(d)) print(a + b) print(c + d) print("The sum of " + str(a) + " and " + str(b) + " is " + str(a + b)) print('The sum of', a, 'and', b, 'is', a+b) print('The sum of', c, 'and', d, 'is', c+d) |
跑程式碼後,在右邊輸入 a, b, c, d 四個數字,例如 3, 4, 5, 6,就會出現:
|
3 4 5 6 <class int=""> <class int=""> <class str=""> <class str=""> 7 56 The sum of 3 and 4 is 7 The sum of 3 and 4 is 7 The sum of 5 and 6 is 56 |
3, 4, 5, 6 是你輸入的數字,後面幾行是程式算出來的。可以看到 3 和 4 是 integer,5 和 6 是 string,所以 3 + 4 算出來是 7,但是 5 + 6 算出來是 56,因為是兩個 string 連在一起,而不是兩個數字加在一起。
以上,這篇的 Python 介紹就先到這吧。
2018年4月8日 星期日
抗發炎藥物似可預防阿茲海默症
如果阿茲海默症的預防可以這麼簡單,那真是好事。
關於阿茲海默症的一些知識可以先看這篇:阿茲海默症新藥 新進度 Aducanumab
或這篇:利用 ASO 治療阿茲海默症
這個研究是 UBC 的教授做的,重點有兩個:
1. Aβ42 不只出現在腦部,全身上下的器官中都有,包括口水中也有,口水中的是由頷下腺(submandibular glands)產生的。口水中的 Aβ42 可以用 ELISA 就測出來,所以其實可以早期發現早期治療,而不是像現在這樣要等到輕微失憶(mild cognitive impairment, MCI)的症狀出來 [註]。在他們的控制組中沒有 AD 症狀的案例)裡,測出的 Aβ42 可以分成兩組,一組是口水中 Aβ42 量較低的(19-25pg/ml),一組是較高的(41-60pg/ml)。低的那組是沒有 AD 風險的 ,他們口水中的 Aβ42 量為約 20pg/ml。
註:AD 進展分為六個階段,一期五年,每五年會惡化一倍。通常症狀會在 65+ 歲顯現出來,倒推回去大概是在 55+ 歲左右開始。第二個階段(第二個五年開始)和第三個階段(第三個五年)可以用 PET scan 測出來。第四個階段會開始出現輕微失智(MCI),海馬迴(hippocampus)的萎縮也可以用 MRI 看出來,這個階段開始,AD 便無法被預防。
AD 的鑑定方法目前有三種:
- CSF (cerebrospinal fluid)裡的 Aβ 和 tau 量是否降低,但因為 CSF 是流動的,這個方法有限制。
- 用 PET scan 看腦中是否有 Aβ 堆積
- 用 MRI 看腦部(尤其是海馬迴的部分)是否有萎縮
2. 普拿疼(Ibuprofen)等的非類固醇抗發炎藥物(nonsteroidal anti-inflammatory drugs, NSAIDs)可以預防阿茲海默症。
相關文章:治療阿茲海默症的另一種可能?
後發性(也就是非基因造成)的阿茲海默症病因一直以來都是個問號,目前皆認同的是因為 Aβ (β-amyloid)和 p-tau 堆積造成腦細胞死亡,進而造成失智。但近來發炎這個現象也被考慮為病因之一,只是還不清楚是因為 Aβ 和 p-tau 堆積才造成發炎,加速惡化,還是因為發炎了才引發堆積。總之,抗發炎這個路徑也在研究治療的範圍之中。
之前就有臨床研究發現,類風濕性關節炎(rheumatoid arthritis, RA)的病患得 AD 的比例較低,但不知道原因。在過去的 25 年間,有很多研究顯示有服用抗發炎藥物的 RA 病患人口,其中有得到 AD 的比例比較低。另外,類風濕性關節炎發作時間比 AD 較早,RA 病患通常在早期就開始吃抗發炎藥物。他們發現服用 NSAIDs 需要在 AD 之前就開始吃,至少吃了半年,最好是已吃了五年以上。
Articles:
NNR / Ibuprofen Can Prevent Alzheimer's Disease -Apparently
Papers:
PL McGeer et al, Alzheimer’s Disease Can Be Spared by Nonsteroidal Anti-Inflammatory Drugs. J Alzheimers Disease (2018)
M Lee et al, A Method for Diagnosing Alzheimer’s Disease Based on Salivary Amyloid- Protein 42 Levels. J Alzheimers Disease (2017)
McGeer et al, Inflammation, Antiinflammatory Agents, and Alzheimer’s Disease: The Last 22 Years. J Alzheimers Disease (2016)
2018年3月31日 星期六
R | ggplot: 整理圖的外觀 - scale, legend
會畫一些基本的圖了以後,這篇要介紹怎麼整理圖的外觀,例如改變兩軸的 scales 或是加標示(legend)等等,讓圖看起來比較清楚又簡單易懂。
關於這篇的課堂講義請看這:R Graphics with Ggplot2 - Day 2
這邊同要需要先跑下面這些 library。
同樣是用檔案資料 mpg,下面之前設好的 p1。(解說看這篇)
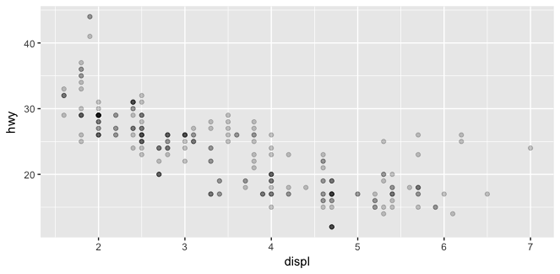
可以改變兩軸的名稱,只要在後面加這個:scale_x_continuous(" ") 和 scale_y_continuous(" "),然後在 " " 裡面打入你想要的軸名就好了。
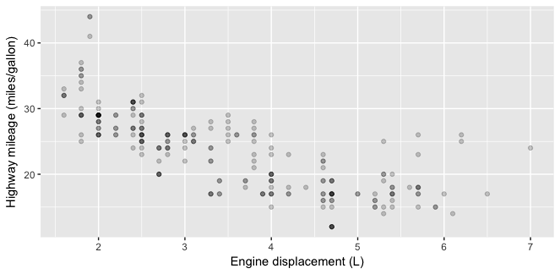
或是也可以簡單點用:xlab(' ') 和 ylab(' '),然後在 ' ' 裡面打你要的軸名。
如果要加上圖的名稱或標題,則是在加上:ggtitle(' ')
也可以全部寫在一起:labs(x = ' ', y = ' ', title = ' ')

我們也可以設定 variable 裡面各個觀察的顏色,例如在這個例子裡,我們加入 year 這個變項,然後用顏色區分。
若要加入年份這個 variable,需要在 geom_point 裡面加入:aes(colour = factor(year)
這個指令也可以加在 p1 那層裡面,在這邊為求方便和易理解,所以加在後面。(細節解釋請看這篇和這篇)
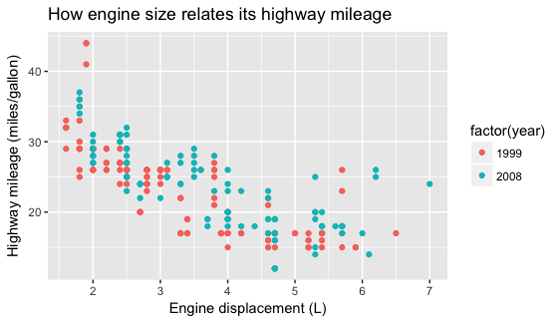
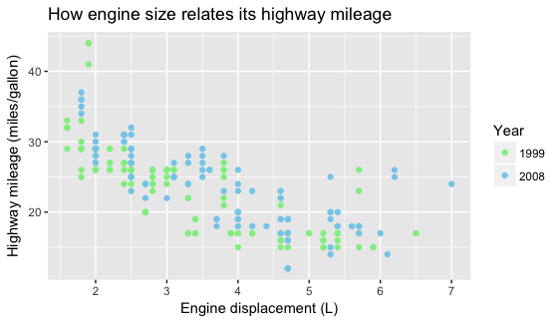
如果想指定這個年份的顏色,可以用下面的語法設定你要的顏色,也可以設定旁邊圖標(figure legend)的名稱,例如把 factor(year) 改為 Year。
scale_colour_manual(name = " ", values = c(" ", " "))
在名字的地方打入你想要的名稱,在 values = c(" ", " ") 的地方打入你要的顏色。
除此之外,你也可以讓圖標只顯示出你要的觀察,例如說只顯示 2008 年的,並且把它改名為 To Date。
只想顯示某個觀察用:bearks =
把那個觀察改名用:labels = " "
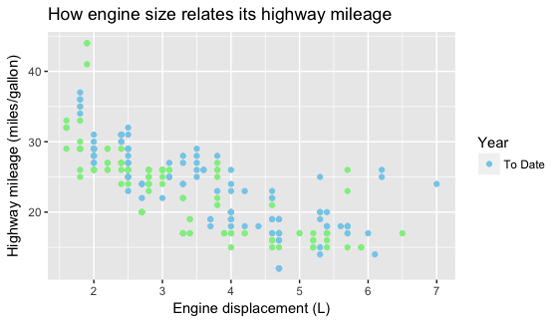
也可以改變圖標的位置,用 theme() 功能裡的 legend.position。
語法是:theme(legend.position = )
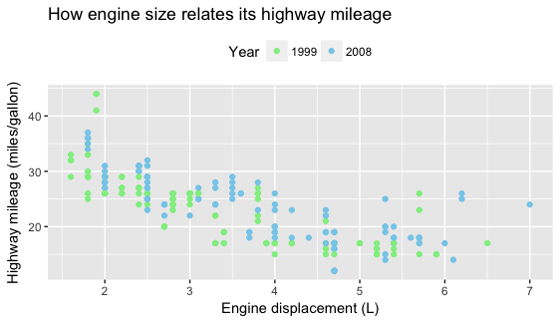
如果不要圖標,就寫 none:theme(legend.position="none")
如果要更細部的挑整圖標,可以用 guides() 的功能。
對應前面的 colour = factor(year),guides() 功能裡面用的是 colour = guide_legend()。可以在 guide_legend() 裡面設定圖標的標題、位置和格式。
設定標題的話就是直接在 guide_legend() 裡面輸入 "title" (title = 你想要的標題)。
設定位置則是用:label.position =
也可以把圖標設成兩欄的格式:ncol =
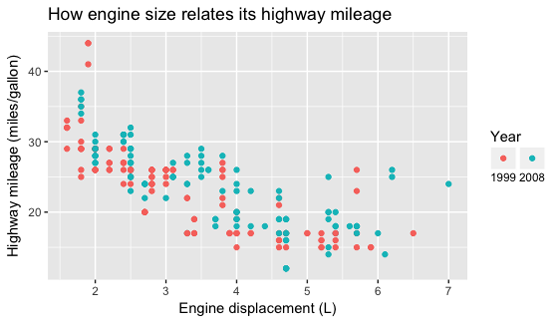
有從上面的圖中看出哪個語法是對應到哪個變化嗎?
接下來,我們用檔案資料 diamonds 來做其他改變。
在之前這一篇有畫過這個圖:
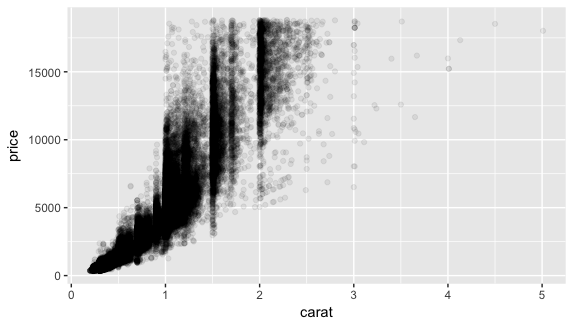
可以在其中加入另一個變項 cut,用顏色區分。
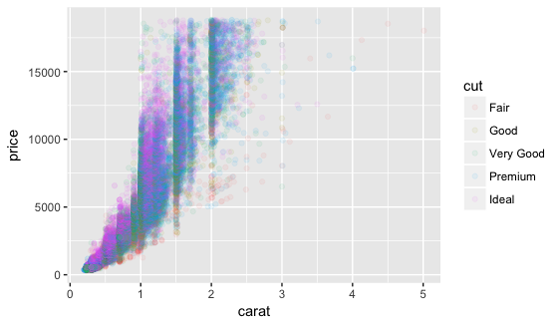
因為點太多,我們可以隨機挑出兩百個點做試驗,並把圖設為 d1。
隨機挑數的語法是:sample_n(dataframe, #)

上面的圖的 Y-axis 間隔都是相同的,我們可以把它改成倍數,也就是用 log 或是 log10。
要改軸的格式可以用上面介紹的 scale_x_continuous() 和 scale_y_continuous()。
在這兩個功能裡面可以設軸名、軸的格式、最大值和最小值,還有顯示哪幾個值。
設軸名:name = " "
設軸上各點的名字:label = c(" ", " ", " ", ...)
例如 X-axis 的標示是 2, 4, 6 的話,可以用 label = c("two", "four", "six") 這個語法改成 two, four, six。
軸的格式可以設成倍數,也就是從原本的 1, 2, 3, .... etc. 轉換成 1, 2, 4, 8, 16, ... etc,用的語法為:trans = "log" 或是 trans = "log10"
最大值和最小值:limits = c(min, max)
也可以用之前介紹過的:xlim(min, max)
只顯示某幾個值:breaks = c(x, y, z, ....)
顯示副軸(minor scale):minor_breaks = (如果沒設的話就是 default 會出現,如果不想要就設 minor_breaks = NULL。)
接下來直接用上面的圖做變化,為了清楚表現以上幾個功能,先從最少的語法開始。下面是

跟上面的比較,可以看出軸名改了,成為:Price 和 Carat。圖的橫軸變成從 0.2 到 4,軸的點為指定的那四點,各點間依比例設距離,因此畫出來會是 log 的圖。圖的直軸也只顯示設的那幾個點,數字間的距離也是依比例畫的。兩軸皆沒有副軸。
再來加入副軸,也就是把 minor_breaks = NULL 拿掉。然後讓顯示的點都為等距,也就是用 trans = "log" 的功能來畫 log 的圖。

再來,我們可以改變圖標的名稱,用的語法是:scale_colour_discrete()

可以看到右邊圖標的名稱改了,如果想要改裡面各個小標的名稱的話,就在功能裡面加:labels = c(" ", " ", " ", ...)
最後,我們用檔案 msleep 來做個練習吧。
Exercise
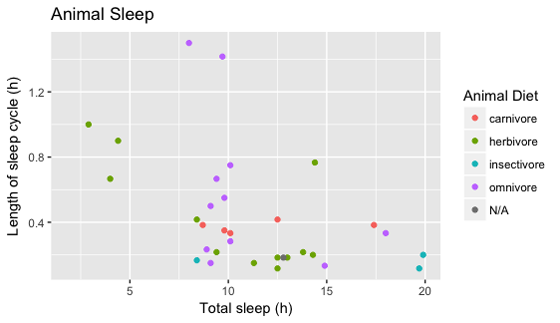
1. Using the msleep data frame, plot the length of the sleep cycle versus the total amount of sleep. Indicate the animal’s diet by colour. Add appropriate labels to the axes and colour legend, and make the colour key labels more reader-friendly.
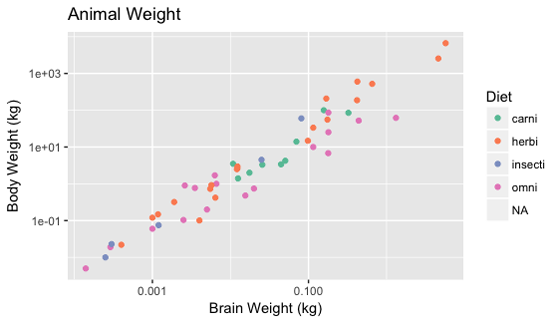
2. Using the msleep data frame, plot the body weight vs. the brain weight. Indicate the animal’s diet by colour. Add appropriate labels to the axes and colour legend. (Use a log axis if warranted.)
這邊我們會用另一個顏色的功能嘗試:scale_colour_brewer()
用法跟上面的很像,一樣是可以在裡面設定圖標名稱,另外就是這個是調色盤,也可以設定不同的色調,用的語法是:palette = " "
另外,上面介紹的 scale_x_continuous(trans = "log10") 和 scale_y_continuous(trans = "log10") 也可以用較短的 scale_x_log10() 和 scale_y_log10() 代替。

如果沒有設定色調的話,預設是藍色。如果想用其他色調的話,可以參考這裡,下面用的是 "Set2"。
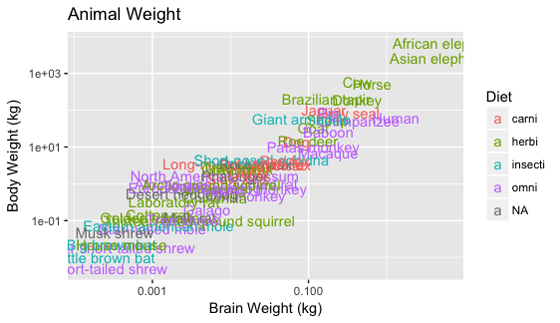
3. Same as Exercise 2, but use the species name instead of a point. Add appropriate labels to the axes and colour legend. (Use a log axis if warranted.)
這邊要把點改成動物名稱,也就是用字去顯示每個點,用的功能是:geom_text()
因為我們要用動物名稱去標示每個點,所以要加入這個指令:label = name
好了,主要的幾個功能大概都介紹了,這篇就先到這邊吧。(總算把這篇打完惹)
關於這篇的課堂講義請看這:R Graphics with Ggplot2 - Day 2
這邊同要需要先跑下面這些 library。
|
library(ggplot2) library(dplyr) data(mpg) data(diamonds) |
同樣是用檔案資料 mpg,下面之前設好的 p1。(解說看這篇)
|
p1 <- ggplot(mpg, aes(displ, hwy)) p1 + geom_point(alpha = 1/5) |
可以改變兩軸的名稱,只要在後面加這個:scale_x_continuous(" ") 和 scale_y_continuous(" "),然後在 " " 裡面打入你想要的軸名就好了。
|
p1 + geom_point(alpha = 1/5) + scale_x_continuous("Engine displacement (L)") + scale_y_continuous("Highway mileage (miles/gallon)") |
或是也可以簡單點用:xlab(' ') 和 ylab(' '),然後在 ' ' 裡面打你要的軸名。
如果要加上圖的名稱或標題,則是在加上:ggtitle(' ')
|
p1 + geom_point(alpha = 1/5) + xlab('Engine displacement (L)') + ylab('Highway mileage (miles/gallon)') + ggtitle('How engine size relates its highway mileage') |
也可以全部寫在一起:labs(x = ' ', y = ' ', title = ' ')
|
p1 + geom_point(alpha = 1/5) + labs(x = 'Engine displacement (L)', y = 'Highway mileage (miles/gallon)', title = 'How engine size relates its highway mileage') |
我們也可以設定 variable 裡面各個觀察的顏色,例如在這個例子裡,我們加入 year 這個變項,然後用顏色區分。
若要加入年份這個 variable,需要在 geom_point 裡面加入:aes(colour = factor(year)
這個指令也可以加在 p1 那層裡面,在這邊為求方便和易理解,所以加在後面。(細節解釋請看這篇和這篇)
|
p1 + geom_point(aes(colour = factor(year))) + labs(x = 'Engine displacement (L)', y = 'Highway mileage (miles/gallon)', title = 'How engine size relates its highway mileage') |
如果想指定這個年份的顏色,可以用下面的語法設定你要的顏色,也可以設定旁邊圖標(figure legend)的名稱,例如把 factor(year) 改為 Year。
scale_colour_manual(name = " ", values = c(" ", " "))
在名字的地方打入你想要的名稱,在 values = c(" ", " ") 的地方打入你要的顏色。
|
p1 + geom_point(aes(colour = factor(year))) + labs(x = 'Engine displacement (L)', y = 'Highway mileage (miles/gallon)', title = 'How engine size relates its highway mileage') + scale_colour_manual(name = "Year", values = c("light green", "skyblue")) |
除此之外,你也可以讓圖標只顯示出你要的觀察,例如說只顯示 2008 年的,並且把它改名為 To Date。
只想顯示某個觀察用:bearks =
把那個觀察改名用:labels = " "
|
ggplot(mpg, aes(hwy, cty, colour = factor(year))) + geom_point() + scale_colour_manual(name = "Year", values = c("light green", "skyblue"), breaks = 2008, labels = "To Date")) |
也可以改變圖標的位置,用 theme() 功能裡的 legend.position。
語法是:theme(legend.position = )
| p1 + geom_point(aes(colour = factor(year))) + labs(x = 'Engine displacement (L)', y = 'Highway mileage (miles/gallon)', title = 'How engine size relates its highway mileage') + scale_colour_manual(name = "Year", values = c("light green", "skyblue")) + theme(legend.position = 'top') |
如果不要圖標,就寫 none:theme(legend.position="none")
如果要更細部的挑整圖標,可以用 guides() 的功能。
對應前面的 colour = factor(year),guides() 功能裡面用的是 colour = guide_legend()。可以在 guide_legend() 裡面設定圖標的標題、位置和格式。
設定標題的話就是直接在 guide_legend() 裡面輸入 "title" (title = 你想要的標題)。
設定位置則是用:label.position =
也可以把圖標設成兩欄的格式:ncol =
|
p1 + geom_point(aes(colour = factor(year))) + labs(x = 'Engine displacement (L)', y = 'Highway mileage (miles/gallon)', title = 'How engine size relates its highway mileage') + guides(colour = guide_legend("Year", label.position = "bottom", ncol = 2)) |
有從上面的圖中看出哪個語法是對應到哪個變化嗎?
接下來,我們用檔案資料 diamonds 來做其他改變。
在之前這一篇有畫過這個圖:
|
ggplot(diamonds, aes(carat, price)) + geom_point(alpha = 1/15) |
可以在其中加入另一個變項 cut,用顏色區分。
|
ggplot(diamonds, aes(carat, price, colour = cut)) + geom_point(alpha = 1/15) |
因為點太多,我們可以隨機挑出兩百個點做試驗,並把圖設為 d1。
隨機挑數的語法是:sample_n(dataframe, #)
|
d1 <- ggplot(sample_n(diamonds, 200), aes(carat, price, colour = cut)) + geom_point() |
上面的圖的 Y-axis 間隔都是相同的,我們可以把它改成倍數,也就是用 log 或是 log10。
要改軸的格式可以用上面介紹的 scale_x_continuous() 和 scale_y_continuous()。
在這兩個功能裡面可以設軸名、軸的格式、最大值和最小值,還有顯示哪幾個值。
設軸名:name = " "
設軸上各點的名字:label = c(" ", " ", " ", ...)
例如 X-axis 的標示是 2, 4, 6 的話,可以用 label = c("two", "four", "six") 這個語法改成 two, four, six。
軸的格式可以設成倍數,也就是從原本的 1, 2, 3, .... etc. 轉換成 1, 2, 4, 8, 16, ... etc,用的語法為:trans = "log" 或是 trans = "log10"
最大值和最小值:limits = c(min, max)
也可以用之前介紹過的:xlim(min, max)
只顯示某幾個值:breaks = c(x, y, z, ....)
顯示副軸(minor scale):minor_breaks = (如果沒設的話就是 default 會出現,如果不想要就設 minor_breaks = NULL。)
接下來直接用上面的圖做變化,為了清楚表現以上幾個功能,先從最少的語法開始。下面是
|
d1 + scale_x_continuous(name = "Carat", limits = c(0.2, 4), breaks = c(0.25, 0.5, 1, 2, 4), minor_breaks = NULL) + scale_y_continuous(name = "Price", breaks = 1000 * c(0.5, 1, 2, 4, 8, 16), minor_breaks = NULL) |
跟上面的比較,可以看出軸名改了,成為:Price 和 Carat。圖的橫軸變成從 0.2 到 4,軸的點為指定的那四點,各點間依比例設距離,因此畫出來會是 log 的圖。圖的直軸也只顯示設的那幾個點,數字間的距離也是依比例畫的。兩軸皆沒有副軸。
再來加入副軸,也就是把 minor_breaks = NULL 拿掉。然後讓顯示的點都為等距,也就是用 trans = "log" 的功能來畫 log 的圖。
|
d1 + scale_x_continuous(name = "Carat", limits = c(0.2, 4), trans = "log", breaks = c(0.25, 0.5, 1, 2, 4)) + scale_y_continuous(name = "Price", trans = "log10", breaks = 1000 * c(0.5, 1, 2, 4, 8, 16) |
再來,我們可以改變圖標的名稱,用的語法是:scale_colour_discrete()
| d1 + scale_x_continuous(name = "Carat", limits = c(0.2, 4), trans = "log", breaks = c(0.25, 0.5, 1, 2, 4)) + scale_y_continuous(name = "Price", trans = "log10", breaks = 1000 * c(0.5, 1, 2, 4, 8, 16) scale_colour_discrete("Cut") |
可以看到右邊圖標的名稱改了,如果想要改裡面各個小標的名稱的話,就在功能裡面加:labels = c(" ", " ", " ", ...)
最後,我們用檔案 msleep 來做個練習吧。
Exercise
1. Using the msleep data frame, plot the length of the sleep cycle versus the total amount of sleep. Indicate the animal’s diet by colour. Add appropriate labels to the axes and colour legend, and make the colour key labels more reader-friendly.
|
ggplot(msleep, aes(sleep_total, sleep_cycle, colour = vore)) + geom_point() + labs(x = "Total sleep (h)", y = "Length of sleep cycle", title = "Animal Sleep") + scale_colour_discrete("Animal Diet", labels = c("carnivore", "herbivore", "insectivore", "omnivore", "N/A")) |
2. Using the msleep data frame, plot the body weight vs. the brain weight. Indicate the animal’s diet by colour. Add appropriate labels to the axes and colour legend. (Use a log axis if warranted.)
這邊我們會用另一個顏色的功能嘗試:scale_colour_brewer()
用法跟上面的很像,一樣是可以在裡面設定圖標名稱,另外就是這個是調色盤,也可以設定不同的色調,用的語法是:palette = " "
另外,上面介紹的 scale_x_continuous(trans = "log10") 和 scale_y_continuous(trans = "log10") 也可以用較短的 scale_x_log10() 和 scale_y_log10() 代替。
|
ggplot(msleep, aes(brainwt, bodywt, colour = vore)) + geom_point() + labs(x = "Brain Weight (kg)", y = "Body Weight (kg)", title = "Animal Weight") + scale_x_log10() + scale_y_log10() + scale_colour_brewer("Diet") |
如果沒有設定色調的話,預設是藍色。如果想用其他色調的話,可以參考這裡,下面用的是 "Set2"。
| ggplot(msleep, aes(brainwt, bodywt, colour = vore)) + geom_point() + labs(x = "Brain Weight (kg)", y = "Body Weight (kg)", title = "Animal Weight") + scale_x_log10() + scale_y_log10() + scale_colour_brewer("Diet", palette = "Set2") |
3. Same as Exercise 2, but use the species name instead of a point. Add appropriate labels to the axes and colour legend. (Use a log axis if warranted.)
這邊要把點改成動物名稱,也就是用字去顯示每個點,用的功能是:geom_text()
因為我們要用動物名稱去標示每個點,所以要加入這個指令:label = name
|
ggplot(msleep, aes(brainwt, bodywt, colour = vore)) + geom_text(aes(label = name)) + labs(x = "Brain Weight (kg)", y = "Body Weight (kg)", title = "Animal Weight") + scale_x_log10() + scale_y_log10() + scale_color_discrete("Diet") |
好了,主要的幾個功能大概都介紹了,這篇就先到這邊吧。(總算把這篇打完惹)
訂閱:
文章 (Atom)